นักวิทยาศาสตร์ OpenAI Noam Brown: ขีด จํากัด ที่แท้จริงของ AI อาจไม่มีใครสามารถวัดได้เลย
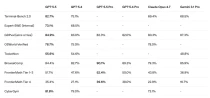
เมื่อโมเดลภาษาขนาดใหญ่เริ่มเข้าสู่งานที่ซับซ้อน เช่น การอนุมาน การวิจัยอัตโนมัติ และความปลอดภัยทางไซเบอร์ วิธีการประเมินโมเดลแบบดั้งเดิมก็กำลังเผชิญกับความท้าทายใหม่ๆมาเป็นเวลานานแล้ว การเปิดตัวโมเดลมักจะมาพร้อมกับตารางผลลัพธ์ที่ประกอบด้วยการทดสอบมาตรฐานหลากหลายประเภท เช่น คณิตศาสตร์ การเขียนโปรแกรม คำถาม-คำตอบทางวิทยาศาสตร์ ความปลอดภัยทางไซเบอร์ และการอนุมานความรู้ และจะมีการเปรียบเทียบผลลัพธ์เหล่านั้นกับโมเดลรุ่นก่อนหน้า